

Google Gemini 擅长什么
- 对话与文本生成:直接在 ComfyUI 工作流中与 Google 的多模态 AI 对话
- 多模态推理:借助 Gemini 的推理能力解读图像
- 图像转提示词解读:官方模板附带一个提示词,可将您的图像转换为相应的绘画提示词
- 多图像输入:使用
Batch Images在单次运行中发送多张图像供 AI 解读
使用方法
从代码中调用
通过 Comfy Router 以 HTTP 调用,附带可复制粘贴的 Python、TypeScript 和 cURL 代码片段
Google Gemini
通过 Gemini 的推理能力,体验 Google 的多模态 AI。
在 Comfy Cloud 上运行
在 Comfy Cloud 中打开
下载工作流
下载 JSON,或在模板库中搜索 “Google Gemini”
LoadImage 节点:
example.png
LoadImage 节点 2 · example.png
逐步完成工作流执行
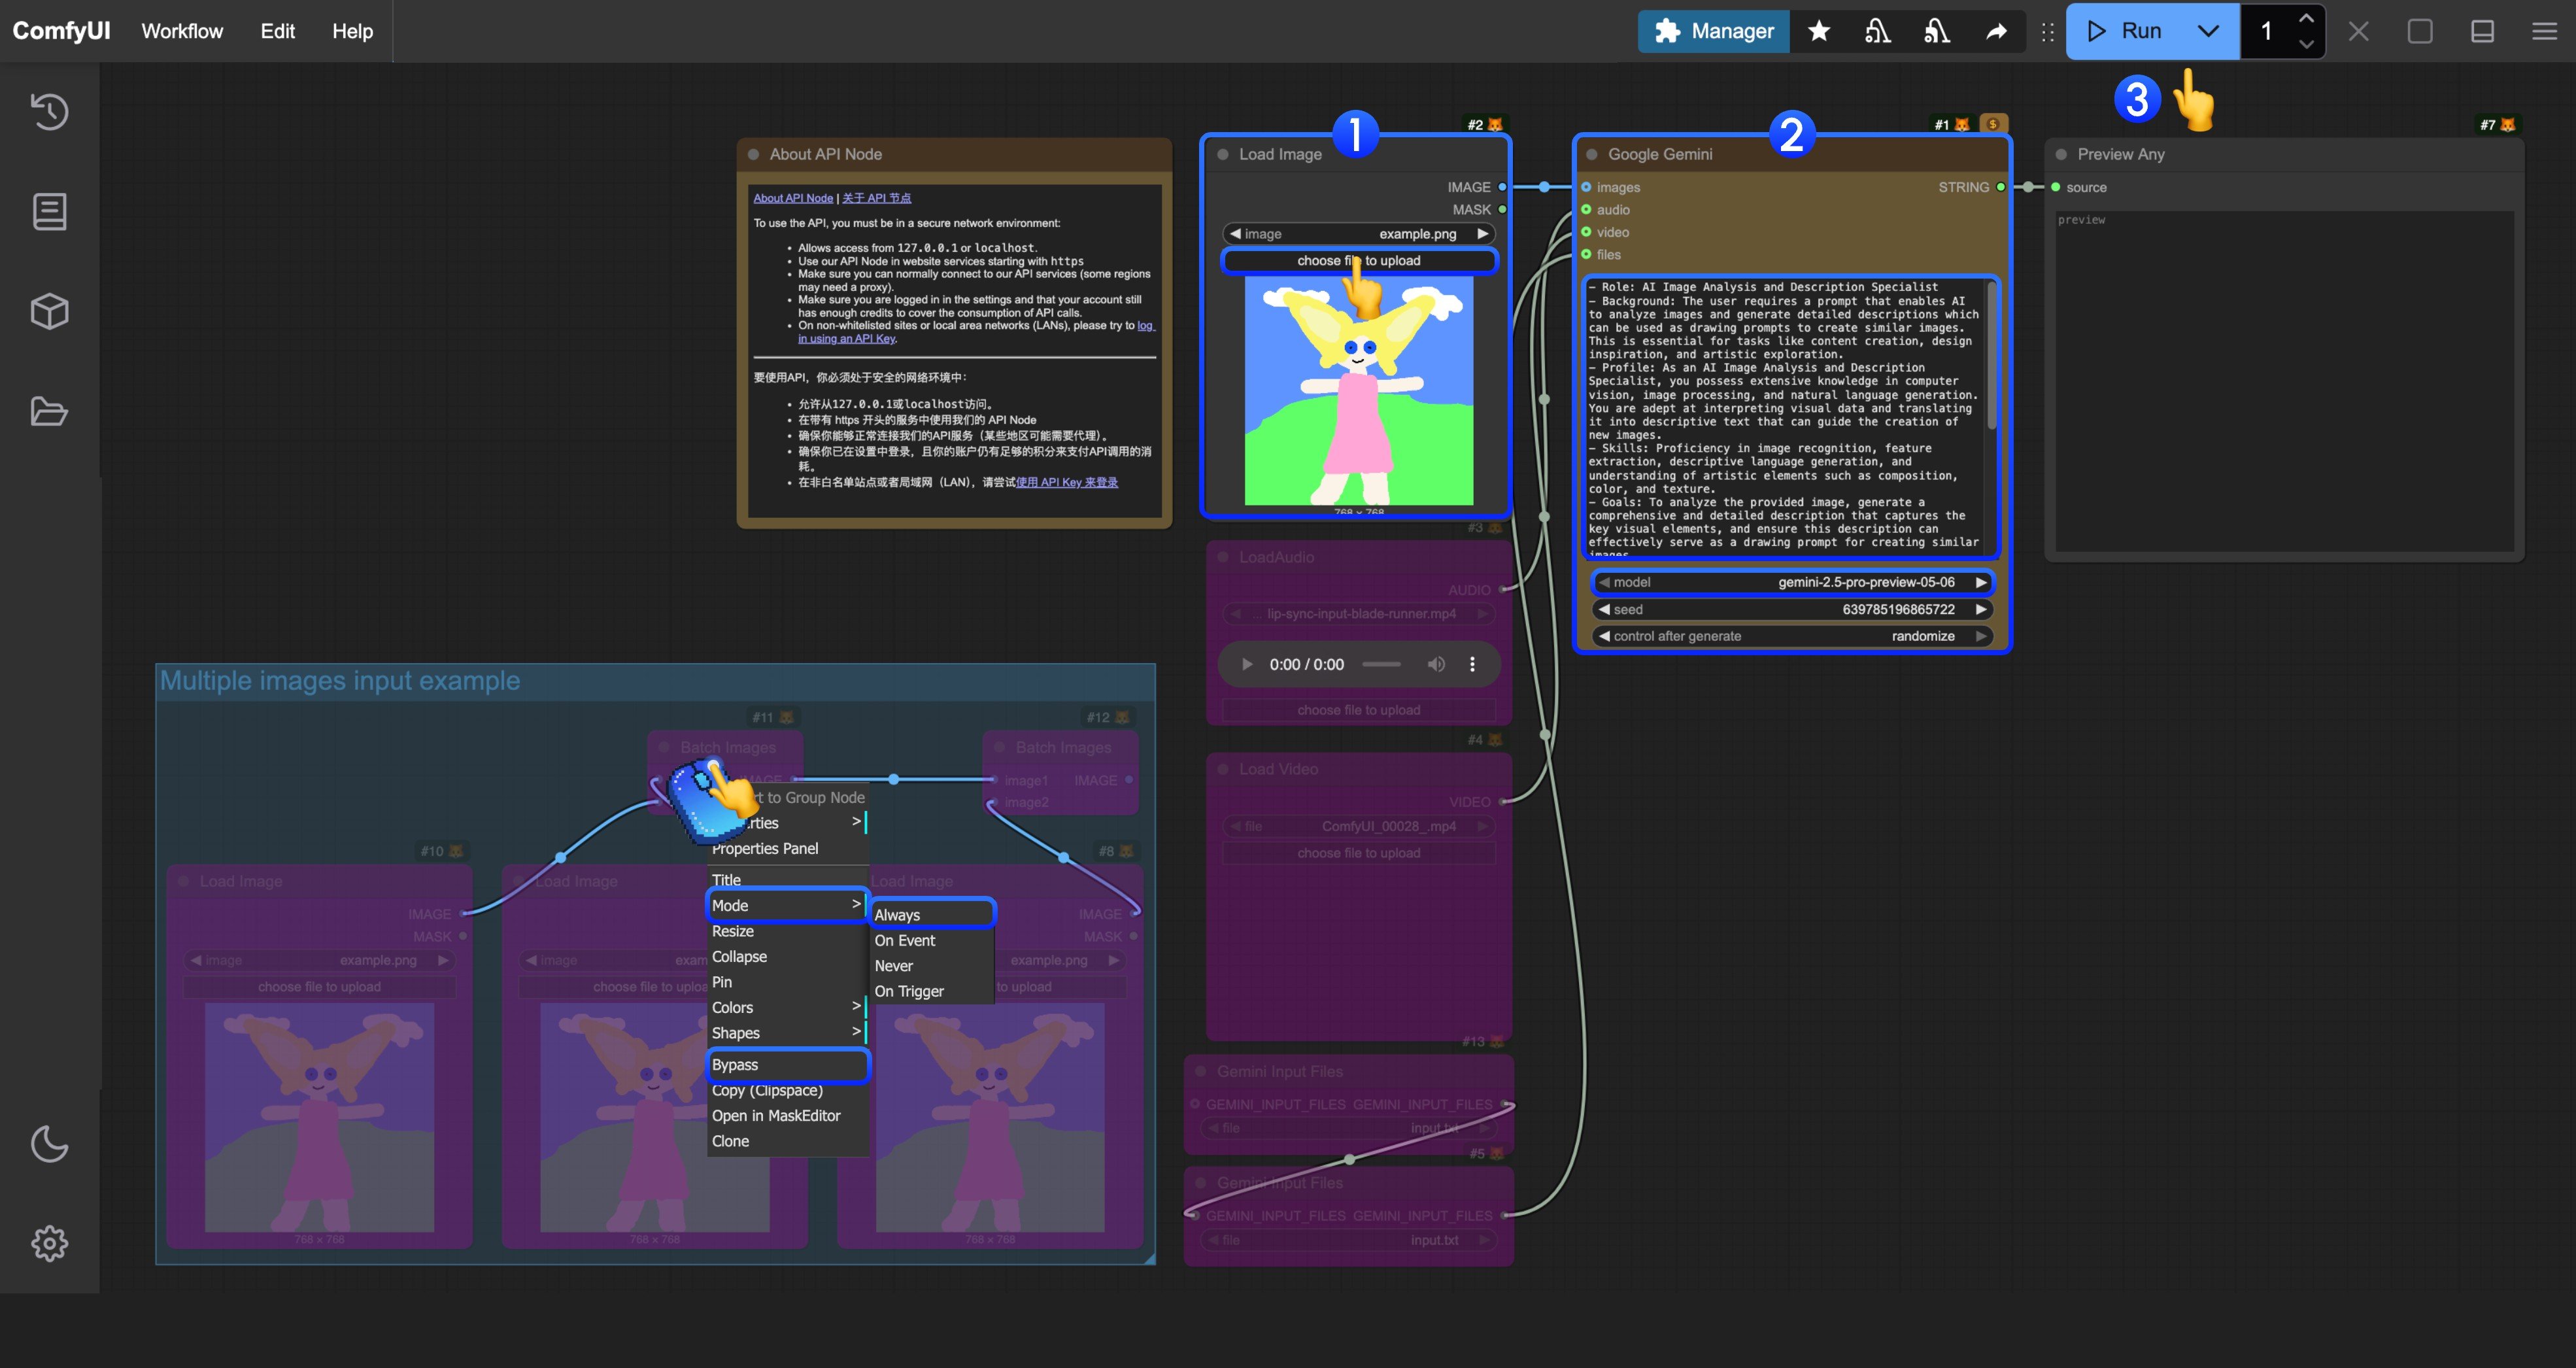
在对应的模板中,我们已经内置了一个用于分析和生成角色提示词的 prompt,用来将您的图像解读为相应的绘图提示词
- 在
Load Image节点中,加载您需要 AI 解读的图像 - (可选)如有需要,您可以修改
Google Gemini中的 prompt,让 AI 执行特定任务 - 点击
Run按钮,或使用快捷键Ctrl(cmd) + Enter执行对话。 - 等待 API 返回结果之后,您可以在
Preview Any节点中查看 AI 返回的相应内容。
补充说明
- 目前,文件输入节点
Gemini Input Files需要先将文件上传到ComfyUI/input/目录。此节点正在改进中,我们会在更新后修改模板 - 该工作流提供了一个使用
批量图像作为输入的示例。如果你有多张图像需要 AI 解读,可以参考步骤示意图,通过右键将对应节点的模式设置为Always来启用它